 ナノトイラボ

今回は、Pythonのスクレイピングという技術を用いて、Webページの見出しをすべて抽出する方法を解説していきます。
具体的には、CSVファイルに書かれたURLから各ページのすべての見出しを抽出する方法です。
参考にしていただけると幸いです。
ゲーム制作に興味があるなら無料オンライン相談を活用しよう!
TECH STADIUM(テックスタジアム) は、数少ないゲーム制作を学べるスクールの中でもかなり評判がよくオススメできるスクールです。
TECH STADIUM(テックスタジアム) を利用し、就職が決まった場合、受講料がすべて返金されるため実質無料でゲーム制作が学べます!

ライブラリのインストール
まずはスクレイピングに必要なライブラリをインストールします。
ローカルの環境でプログラムを実行する場合は、コマンドプロンプトやターミナルを開いてください。
また、Google Colaboratoryで行う場合はColab上で次のプログラムを実行してください。
pip install requests
pip install BeautifulSoup
スクレイピングでURLから情報を取得する
まずは、対象となるURLの設定と、そのURLに対してリクエストを送り、HTMLを取得しましょう。
import requests
from bs4 import BeautifulSoup
import re

# URLを設定し、リクエストを送る
url = "https://nano-toy-lab.com/python/pyscript/"
rest = requests.get(url)
次にBeautifulSoupを利用し、HTMLを解析します。正規表現を用いて、H1~H6の見出しをすべて抽出してみました。
プログラムを読めば直感的にわかるので初心者でも安心です。
# BeautifulSoupにページ内容を読み込ませる
soup = BeautifulSoup(rest.text, "html.parser")

# 見出しとurlの情報を取得して出力する
pattern = re.compile('h[1-6]')

data_list = soup.find_all(pattern)
for data in data_list:
    print(("{} : {}").format(data.name, data.text))

"""
h1 : 【PyScript】HTMLファイルに書くPythonを徹底解説!ローカルサーバでWebブラウザで実行してみよう!
h2 : PyScriptの実行手順
h3 : ローカルサーバを立てる
h3 : Webブラウザ上で出力
h2 : 外部ライブラリの使い方
h2 : HTMLタグを利用して出力
h2 : 自作モジュールのインポート
h3 : 自作モジュールの作成
h3 : HTMLタグから自作モジュールを呼び出す
h2 : グラフを表示してみる
h2 : まとめ
h3 : コメントを残す コメントをキャンセル
h4 : スポンサーリンク
h4 : フォローお願いします!
h4 : ブログ村参加しています!
h4 : カテゴリー
h4 : スポンサーリンク
h4 : 人気記事
h4 : スポンサーリンク
h4 : 最新記事
h4 : アーカイブ
h4 : 目次
"""
csvファイルに書かれたURLの見出しをすべて抽出する
先ほどとの違いは、csvファイルのデータをpandasというモジュールを新たにインストールし、「read_csv」という関数を用いて、データを扱うことです。
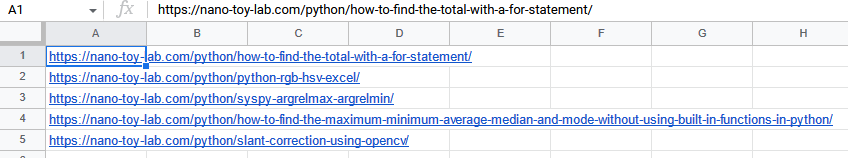
今回扱うCSVファイルの中身はURLが書かれたものになっています。
import requests
from bs4 import BeautifulSoup
import re
import pandas as pd

# CSVファイルの読み込み
df = pd.read_csv('urls.csv', header=None, names=['urls'], encoding="utf-8")

# CSVファイルを最終行まで繰り返す
for i in range(len(df)):
    # CSVデータのi行0列目のデータを取得
    url = df.iloc[i, 0]

    # 対象のURLにリクエストを送る
    rest = requests.get(url)

    # BeautifulSoupにヤフーニュースのページ内容を読み込ませる
    soup = BeautifulSoup(rest.text, "html.parser")

    # 見出しとurlの情報を取得して出力する
    pattern = re.compile('h[1-6]')

    data_list = soup.find_all(pattern)
    for data in data_list:
        print(("{} : {}").format(data.name, data.text))

    print("「{}」 の記事は終了===============\n".format(soup.find('title').text))

"""
h1 : 【Python】for文で合計を求める方法!数学的処理を用いた計算コストも解説!
h2 : sum関数を用いる
h2 : for文を用いる
h2 : 数学的に考えて計算コストを抑える
h3 : 処理時間の計測
h3 : 合計を求めてみる
h2 : キー入力した整数の合計を求める
h2 : まとめ
h3 : コメントを残す コメントをキャンセル
h4 : スポンサーリンク
h4 : フォローお願いします!
h4 : ブログ村参加しています!
h4 : カテゴリー
h4 : スポンサーリンク
h4 : 人気記事
h4 : スポンサーリンク
h4 : 最新記事
h4 : アーカイブ
h4 : 目次
「【Python】for文で合計を求める方法!数学的処理を用いた計算コストも解説! | ナノトイラボ」 の記事は終了===============

(以下省略)
"""
まとめ
最後まで読んでいただきありがとうございます。
今回は、Pythonのスクレイピングで、URLから記事やサイトの見出しをすべて抽出する方法を解説しました。
案外簡単に見出しを抽出できるんだなと思ったと思います。本記事が少しでも皆様の役に立てば幸いです。
ゲーム制作に興味があるなら無料オンライン相談を活用しよう!
TECH STADIUM(テックスタジアム) は、数少ないゲーム制作を学べるスクールの中でもかなり評判がよくオススメできるスクールです。
TECH STADIUM(テックスタジアム) を利用し、就職が決まった場合、受講料がすべて返金されるため実質無料でゲーム制作が学べます!